Sur cette page
En bref : Utilisez la vision par règles lorsqu’une caractéristique stable et mesurable sépare les bonnes pièces des mauvaises. Envisagez la vision par apprentissage (IA) lorsque la variabilité réelle met en échec une règle bien conçue et que vous disposez d’images étiquetées représentatives. Décidez d’après la façon dont chaque approche échoue, et non d’après la plus récente.
Commencer par l’image, pas par l’algorithme
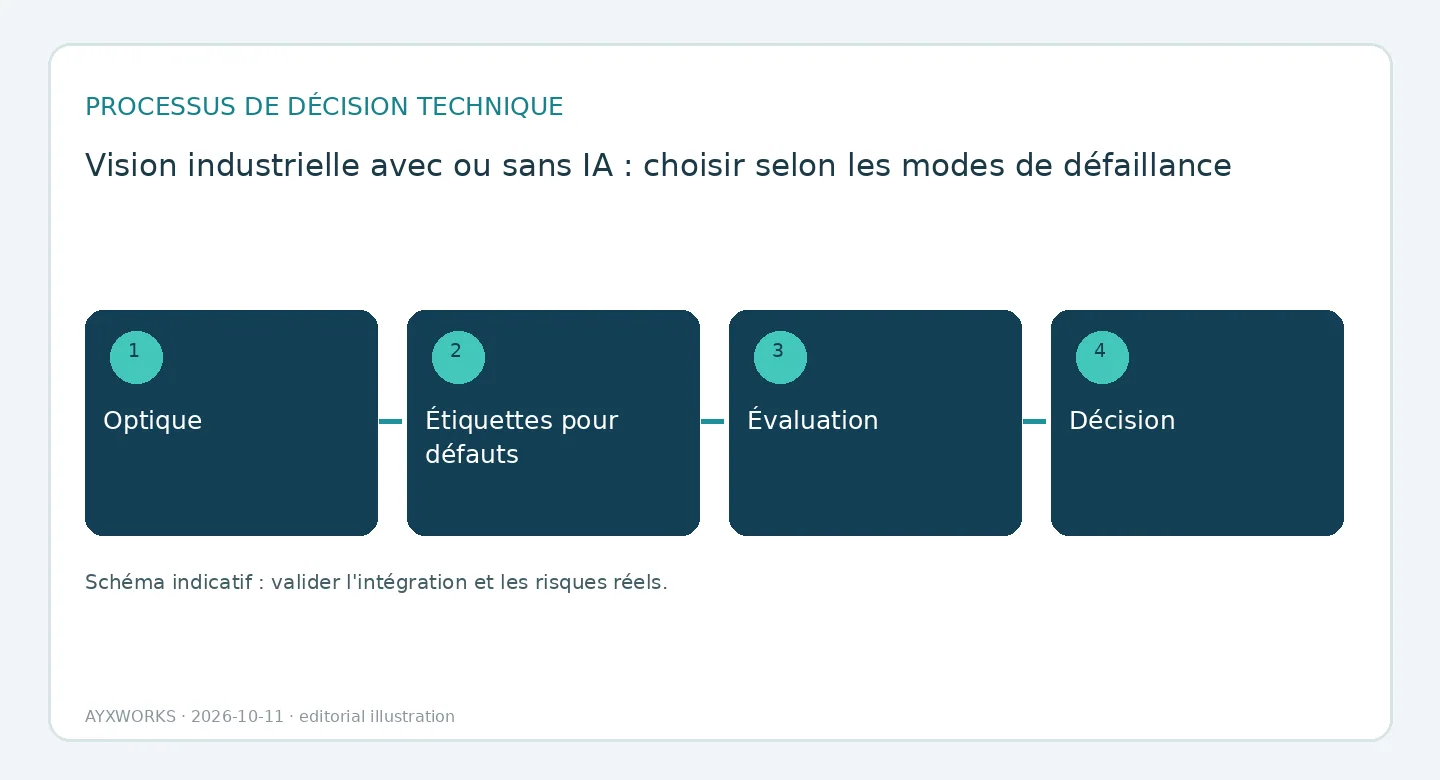
L’angle d’éclairage, l’exposition, la distorsion de l’objectif, la profondeur de champ, le flou de mouvement et la répétabilité du montage déterminent ce que les pixels peuvent montrer. Aucun algorithme, classique ou neuronal, ne retrouve un détail que le capteur n’a jamais saisi. Figez donc d’abord le montage optique, et faites en sorte que les ingénieurs qualité s’accordent sur ce qui constitue un défaut, échantillons limites à l’appui, avant de comparer le moindre logiciel. Si deux contrôleurs sont en désaccord sur une pièce, un modèle entraîné sur leurs étiquettes hérite de ce désaccord.
Là où les règles sont solides, et comment elles échouent
Un outil à base de règles mesure quelque chose d’explicite : la position d’une arête, l’aire d’une région, une distance sous géométrie calibrée, un code qui se lit ou non. Les contrôles de présence, le contrôle dimensionnel, l’alignement sur des caractéristiques très contrastées et la lecture de codes sont donc déterministes et explicables. Lorsqu’une pièce est rejetée, la valeur mesurée et la limite vous disent pourquoi. Les règles échouent lorsque la caractéristique cesse d’être stable : un état de surface différent, un reflet ou la texture d’un nouveau fournisseur déplacent le seuil, et quelqu’un doit le régler de nouveau à la main.
Là où les modèles appris aident, et ce qu’ils coûtent
Un modèle entraîné de classification ou de segmentation apprend à partir d’exemples à quoi ressemblent le bon et le mauvais. Cela aide pour les défauts de texture ou d’aspect et pour les arrière-plans variables, difficiles à formuler sous forme de règle. Le coût est un autre type de travail : collecter et étiqueter des images, gérer les versions du modèle et surveiller la dérive lorsque la production change. Un modèle appris échoue aussi autrement. Il peut renvoyer une réponse assortie d’une confiance élevée pour une image qui ne ressemble à rien de ses données d’entraînement, et la raison d’une décision donnée est plus difficile à lire.
Mesurer séparément les deux types d’erreur
Une fausse acceptation laisse partir un défaut ; un faux rejet met au rebut ou fait retoucher une bonne pièce. Leurs coûts diffèrent : présentez-les donc séparément et par classe de défaut, et non sous la forme d’un seul chiffre d’exactitude. Réservez comme données de test des familles de pièces, des lots ou des périodes de production entiers, afin que le modèle ne soit pas noté sur des images presque identiques à celles qu’il a apprises. Le cadre de gestion des risques liés à l’IA du NIST formule la même idée générale pour tout système d’IA : les performances doivent être démontrées dans des conditions proches du contexte de déploiement, et les systèmes doivent être testés avant le déploiement puis régulièrement en exploitation. Mesurez aussi le temps d’inférence sous charge de ligne, car le pire cas détermine le temps de cycle.
Prévoir la solution de repli et le processus de modification
Décidez qui est responsable du seuil, qui approuve une nouvelle version du modèle et combien de temps les images sont conservées. Définissez ce que fait le poste de contrôle lorsque la caméra se déconnecte, que l’optique s’encrasse ou que la confiance est faible ; orienter la pièce vers un contrôle manuel est la réponse habituelle. Les deux approches peuvent aussi se combiner, avec des règles pour la présence et les dimensions et un modèle appris pour l’aspect de surface. La sortie d’un classifieur n’est pas une fonction de sécurité validée et ne doit pas être utilisée comme telle.
Liste de contrôle avant d’engager un budget ou un périmètre
- Des images représentatives de bonnes pièces et de chaque classe de défaut, avec des échantillons limites validés par la qualité.
- La preuve que l’éclairage et le montage restent stables d’une équipe à l’autre et d’un lot à l’autre.
- Les taux de fausse acceptation et de faux rejet par classe de défaut, mesurés sur des données réservées.
- Le temps d’inférence dans le pire cas, mesuré en conditions de ligne.
- Une solution de repli définie en cas de confiance faible, d’objectif sale ou de perte de la caméra.
- Un responsable désigné pour les seuils, les versions du modèle et la surveillance de la dérive.
Ce que ce guide n’établit pas
Ce guide est une aide à la planification. Il ne présente pas d’essais, ne compare pas de produits et ne prédit le taux de détection d’aucun système sur vos pièces ; cela ne peut se mesurer que sur votre ligne, avec vos images. Un contrôle qui alimente une décision de sécurité ou réglementaire exige sa propre validation par des intervenants dûment qualifiés.
Sources et vérifications complémentaires
- NIST — AI Risk Management Framework (AI RMF 1.0), Core: Govern, Map, Measure, Manage (cadre de 2023 ; le NIST indique qu’une révision est en cours ; consulté le 2026-10-12).
- Association for Advancing Automation (A3) — What Every Machine Vision User Should Know About Lighting (date indiquée : 2002-02-12 ; lecture de référence sur l’éclairage ; consulté le 2026-10-11).
Prochaine étape utile
Apportez des images types de pièces bonnes et défectueuses, vos définitions de défauts, la cadence de la ligne et les résultats de contrôle dont vous disposez déjà sur la page Robotique et automatisation. Le portfolio AYXWORKS présente la démarche d’ingénierie qui sous-tend ces guides. Tout projet qui en découle est défini et réalisé par l’intermédiaire d’Eurobots/ReBots, et il commence par la faisabilité et les limites de responsabilité, non par une installation clé en main supposée.
Crédit photo: Max Gruber — Wikimedia Commons (CC BY 4.0; cropped to 16:9).



