Auf dieser Seite
Kurz gesagt: Regelbasierte Bildverarbeitung eignet sich, wenn ein stabiles, messbares Merkmal Gut- und Schlechtteile trennt. Gelernte, KI-basierte Verfahren kommen infrage, wenn reale Schwankungen eine gut entwickelte Regel überfordern und repräsentative, gelabelte Bilder vorliegen. Entscheiden Sie anhand der jeweiligen Fehlerbilder — nicht danach, welcher Ansatz neuer ist.
Beim Bild beginnen, nicht beim Algorithmus
Beleuchtungswinkel, Belichtung, Objektivverzeichnung, Schärfentiefe, Bewegungsunschärfe und die Wiederholgenauigkeit der Vorrichtung bestimmen, was die Pixel zeigen können. Kein klassischer oder neuronaler Algorithmus stellt Details wieder her, die der Sensor nie erfasst hat. Stabilisieren Sie deshalb zuerst den optischen Aufbau. Bevor Software verglichen wird, muss die Qualitätssicherung anhand von Grenzmustern klären, was als Fehler gilt. Sind sich zwei Prüfpersonen bei einem Teil uneinig, übernimmt ein mit ihren Labels trainiertes Modell diesen Widerspruch.
Wo Regeln überzeugen — und wo sie scheitern
Ein regelbasiertes Werkzeug misst etwas ausdrücklich Definiertes: die Lage einer Kante, die Fläche eines Bereichs, einen Abstand bei kalibrierter Geometrie oder ob sich ein Code lesen lässt. Anwesenheitsprüfung, Maßprüfung, Ausrichtung an kontrastreichen Merkmalen und Codelesen sind damit deterministisch und nachvollziehbar. Wird ein Teil ausgeschleust, erklären Messwert und Grenzwert den Grund. Regeln scheitern, wenn das Merkmal seine Stabilität verliert: Eine andere Oberflächenbeschaffenheit, eine Reflexion oder die Textur eines neuen Lieferanten verschiebt den Schwellenwert, den anschließend jemand von Hand nachstellen muss.
Wo gelernte Modelle helfen — und welche Arbeit sie erfordern
Ein trainiertes Klassifikations- oder Segmentierungsmodell lernt anhand von Beispielen, wie Gut- und Schlechtteile aussehen. Das hilft bei Texturen, kosmetischen Fehlern und wechselnden Hintergründen, die sich schwer in Regeln fassen lassen. Dafür entsteht eine andere Art von Aufwand: Bilder erfassen und labeln, Modellversionen verwalten und nach Produktionsänderungen auf Drift achten. Auch das Fehlerverhalten ist anders. Ein gelerntes Modell kann für ein Bild, das seinen Trainingsdaten überhaupt nicht ähnelt, eine selbstsichere Antwort liefern. Der Grund für eine einzelne Entscheidung ist schwerer zu erkennen.
Beide Fehlerarten getrennt messen
Eine Falschannahme lässt ein fehlerhaftes Teil passieren; eine Falschrückweisung führt zur Nacharbeit oder zum Ausschuss eines guten Teils. Da die Kosten unterschiedlich sind, sollten beide Fehlerarten getrennt und je Fehlerklasse ausgewiesen werden, nicht nur als Gesamtgenauigkeit. Halten Sie vollständige Teilefamilien, Chargen oder Produktionszeiträume als Testdaten zurück, damit das Modell nicht anhand nahezu identischer Trainingsbilder bewertet wird. Das NIST AI Risk Management Framework formuliert denselben Grundsatz für KI-Systeme allgemein: Die Leistung sollte unter einsatznahen Bedingungen nachgewiesen und vor der Einführung sowie regelmäßig im Betrieb geprüft werden. Messen Sie auch die Inferenzdauer unter Linienlast, denn der ungünstigste Fall bestimmt die erreichbare Taktzeit.
Rückfallverfahren und Änderungen planen
Klären Sie, wer den Schwellenwert verantwortet, neue Modellversionen freigibt und die Bildaufbewahrung festlegt. Definieren Sie die Reaktion bei getrennter Kamera, verschmutzter Optik oder geringer Konfidenz; häufig werden die betroffenen Teile zur manuellen Prüfung weitergeleitet. Beide Ansätze lassen sich auch kombinieren: Regeln für Anwesenheit und Maße, ein gelerntes Modell für die Oberflächenbewertung. Die Ausgabe eines Klassifikators ist keine validierte Sicherheitsfunktion und darf nicht als solche verwendet werden.
Checkliste vor Budget- oder Auftragsfreigabe
- Repräsentative Bilder von Gutteilen und jeder Fehlerklasse sowie mit der Qualitätssicherung abgestimmte Grenzmuster bereitstellen.
- Die Stabilität von Beleuchtung und Vorrichtungen über Schichten und Chargen hinweg nachweisen.
- Falschannahmen und Falschrückweisungen je Fehlerklasse an zurückgehaltenen Daten messen.
- Die ungünstigste Inferenzdauer unter Produktionsbedingungen messen.
- Rückfallverfahren für geringe Konfidenz, verschmutzte Optik und Kameraausfall festlegen.
- Verantwortliche für Schwellenwerte, Modellversionen und Driftüberwachung benennen.
Was dieser Leitfaden nicht nachweist
Dieser Leitfaden ist eine Planungshilfe. Er berichtet keine Versuche, vergleicht keine Produkte und sagt keine Erkennungsrate für Ihre Teile voraus. Diese lässt sich nur mit Ihren Bildern an Ihrer Linie messen. Prüfungen, deren Ergebnisse sicherheitsbezogene oder regulatorische Entscheidungen beeinflussen, benötigen eine eigene Validierung durch entsprechend qualifizierte Beteiligte.
Quellen und weitere Prüfung
- NIST — AI Risk Management Framework (AI RMF 1.0), Core: Govern, Map, Measure, Manage (Rahmenwerk von 2023; laut NIST ist eine Überarbeitung in Arbeit; abgerufen am 2026-10-12).
- Association for Advancing Automation (A3) — Was Anwender industrieller Bildverarbeitung über Beleuchtung wissen sollten (angegebenes Datum 2002-02-12; Hintergrundinformationen zur Beleuchtung; abgerufen am 2026-10-11).
Der nächste sinnvolle Schritt
Musterbilder von Gut- und Schlechtteilen, Fehlerdefinitionen, Liniengeschwindigkeit und bereits vorhandene Prüfergebnisse bilden die Grundlage für den Einstieg über die Seite Robotik und Automation. Das AYXWORKS-Portfolio beschreibt den technischen Ansatz dieser Leitfäden. Daraus entstehende Projekte werden über Eurobots/ReBots abgegrenzt und umgesetzt. Sie beginnen mit Machbarkeit und klaren Verantwortungsgrenzen, nicht mit einer vorausgesetzten schlüsselfertigen Installation.
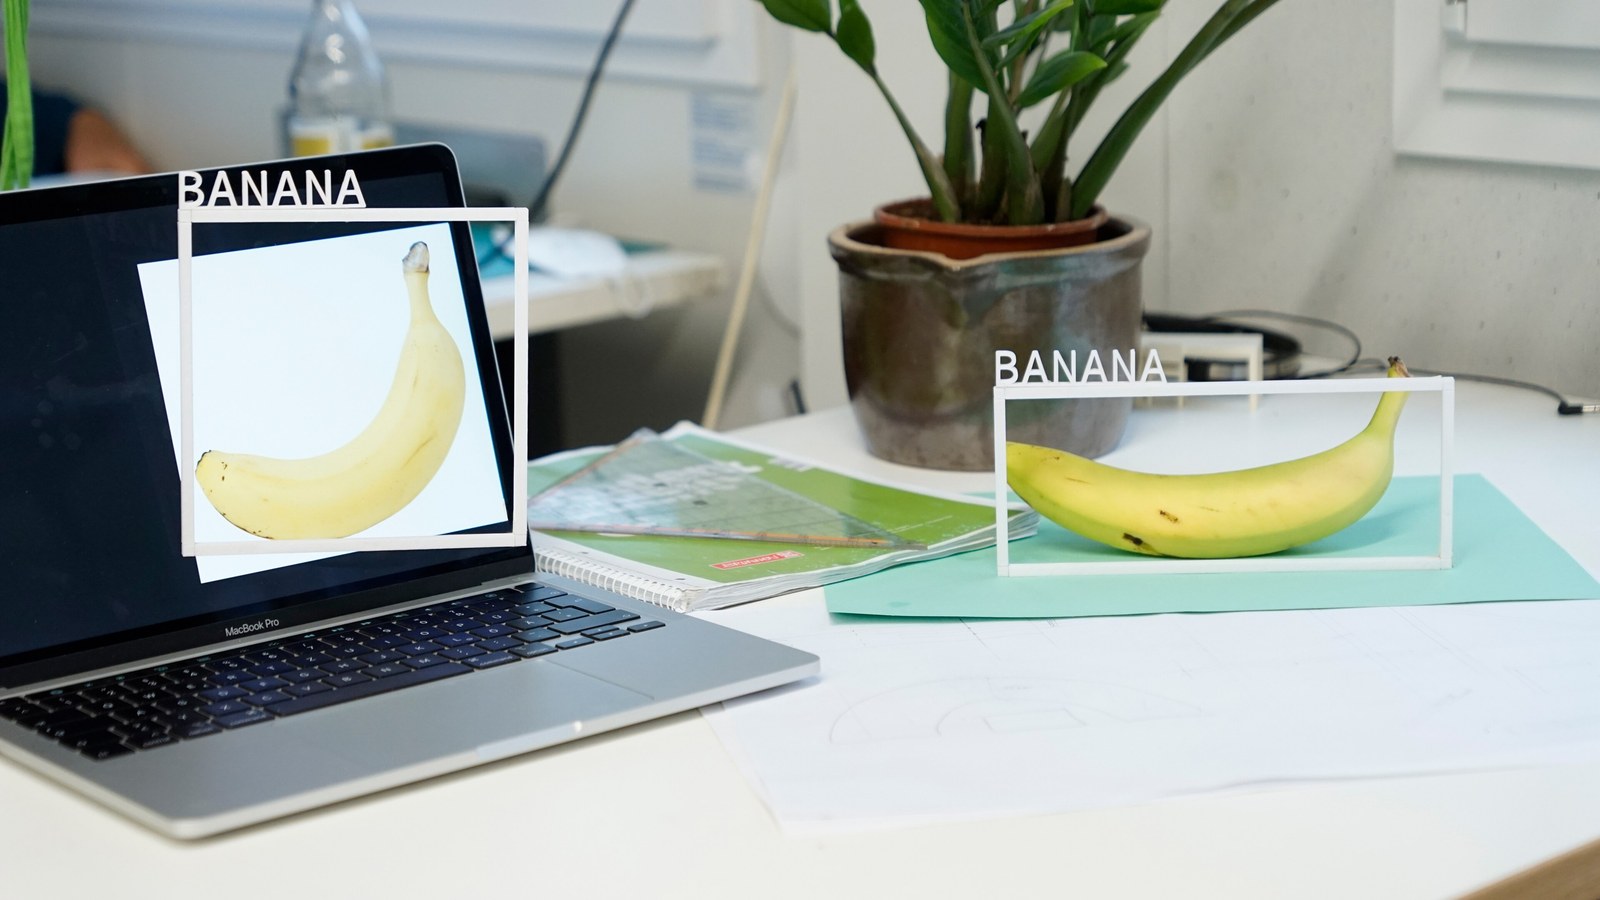
Bildnachweis: Max Gruber — Wikimedia Commons (CC BY 4.0; auf 16:9 zugeschnitten).