Auf dieser Seite
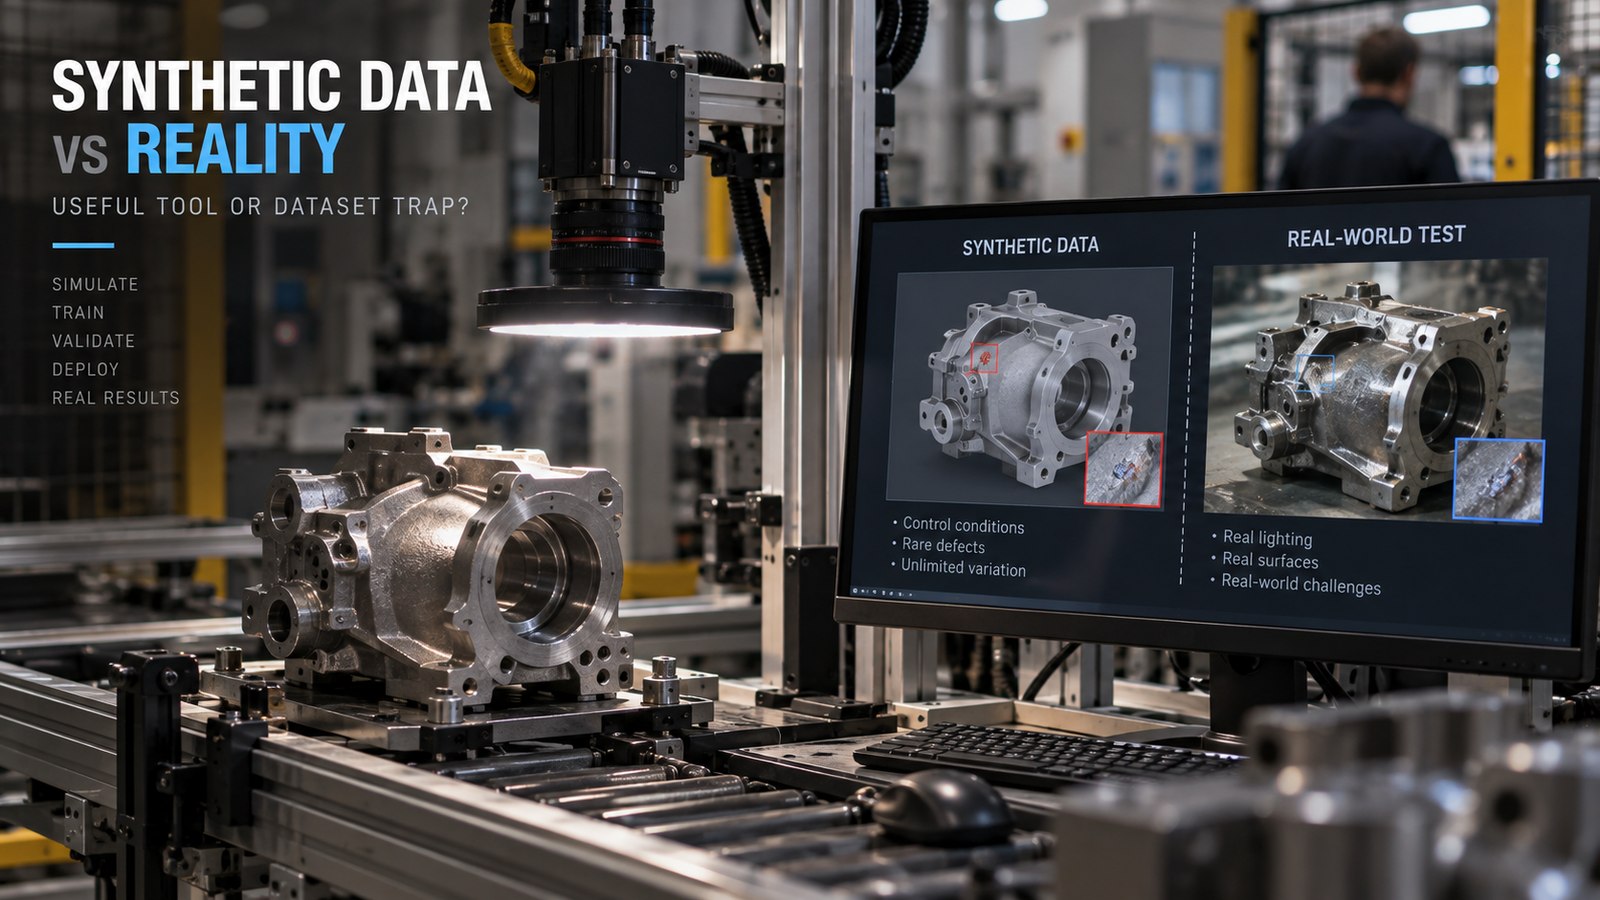
Kurz gesagt: Synthetische Bilder können seltene oder aufwendig zu erfassende Varianten abdecken. Eine gute Punktzahl auf generierten Bildern sagt aber nichts über die Produktionslinie aus. Ob die zusätzlichen Daten helfen, muss ein unabhängiger Satz realer Bilder zeigen.
Was gerenderte Bilder beitragen können
In einer gerenderten Szene lassen sich Kameraposition, Materialien, Beleuchtung, Unordnung und seltene Fehler variieren, ohne jede Konfiguration real aufzubauen. Die Beschriftungen entstehen zusammen mit dem Bild: Der Renderer kennt Positionen von Objekten und Defekten, sodass Masken und Begrenzungsrahmen nicht von Hand erstellt werden müssen. Besonders nützlich kann das am Projektanfang sein, bevor ausreichend reale Fehlerbilder vorliegen, und bei seltenen Bedingungen.
Wo die Domänenlücke entsteht
Echte Oberflächen streuen und reflektieren Licht komplexer als ein Materialmodell; Staub, Öl und Kratzer kommen hinzu. Teile haben mechanische Toleranzen, Kameras erzeugen Rauschen und Unschärfe. Ein für Menschen überzeugendes Rendering kann genau das Merkmal vermissen lassen, auf das ein Modell sich verlässt, oder ein künstliches Merkmal enthalten, das es stattdessen lernt. Synthetische Defekte schaffen ein weiteres Risiko: Weichen Form oder Textur von realen Fehlern ab, lernt das Modell das falsche Konzept und erzielt trotzdem gute synthetische Testergebnisse.
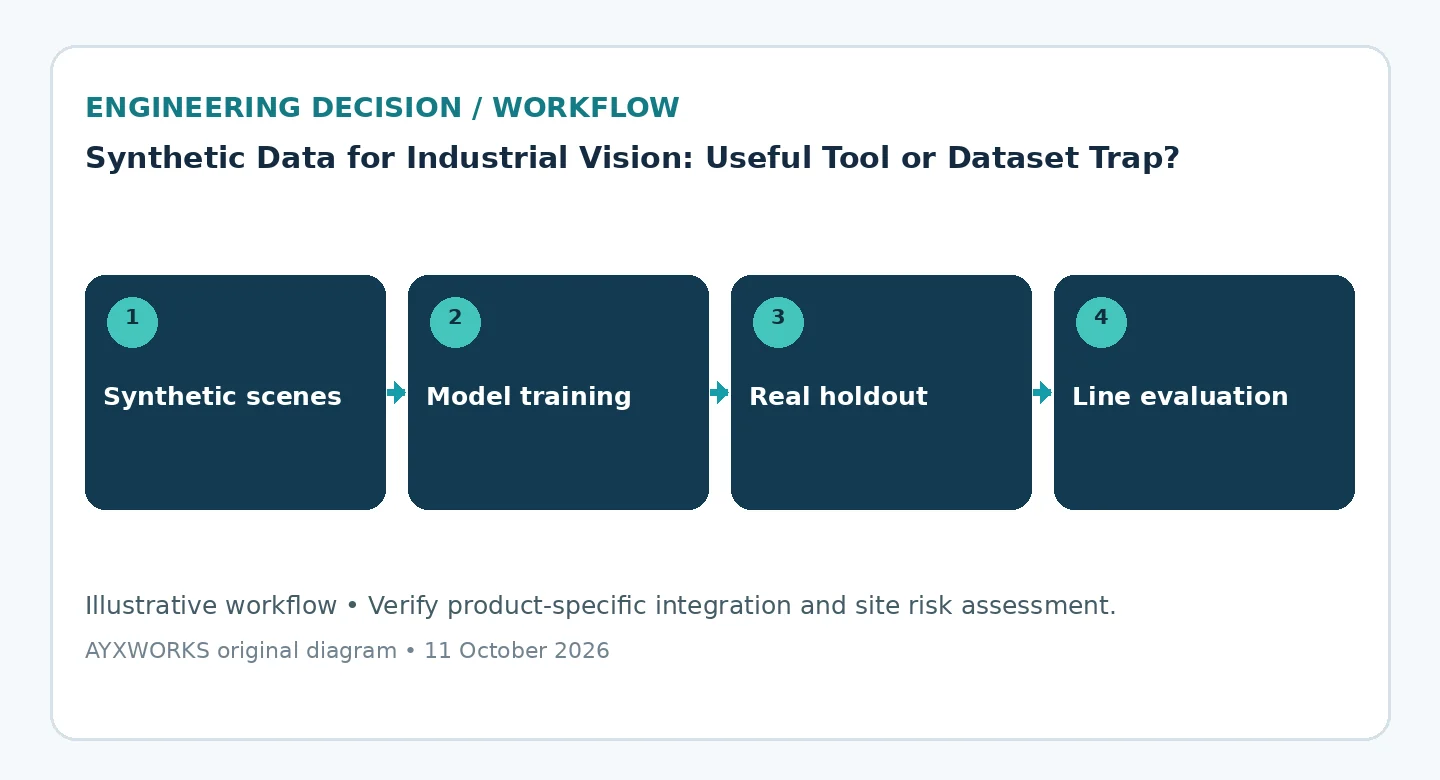
Training, Validierung und abschließenden Test strikt trennen
Teilen Sie reale Fabrikbilder vor der Entwicklung in Trainings-, Validierungs- und abschließende Holdout-Testdaten. Validierungsdaten dienen der Iteration; der finale Test darf weder Training noch Parameterabstimmung oder Modellauswahl beeinflussen. Decken Sie relevante Schichten, Lieferanten, Oberflächen und Kamerakonfigurationen ab, ohne fast identische Bilder über die Teilmengen zu verteilen. Vergleichen Sie einen festgelegten Ausgangsstand und einen festgelegten Kandidaten auf den zurückgehaltenen realen Fällen. Berichten Sie falsche Annahmen und falsche Ausschleusungen pro Fehlerklasse sowie insgesamt. Werden Testergebnisse wiederholt für Anpassungen verwendet, sind sie zu Entwicklungsdaten geworden und ein neuer unberührter Abschlusstest ist nötig. Der Nutzen synthetischer Daten braucht repräsentative reale Belege, nicht nur einen höheren synthetischen Benchmarkwert.
Was die Werkzeugankündigung im Oktober 2026 aussagt
Am 16. März 2026 kündigte NVIDIA den Physical AI Data Factory Blueprint als offene Referenzarchitektur an, die Erzeugung, Erweiterung und Bewertung von Trainingsdaten vereinheitlichen und automatisieren soll. Laut Mitteilung bewertet, prüft und filtert die Komponente Cosmos Evaluator generierte Daten automatisch. Damals wurde eine GitHub-Veröffentlichung für April in Aussicht gestellt. Die Mitteilung nennt keine quantitativen Leistungsresultate und enthält einen Hinweis auf zukunftsgerichtete Aussagen. Eine Plausibilitätsprüfung generierter Daten misst nicht die Leistung Ihres Modells an Ihrer Linie. Die damalige Verfügbarkeitsprognose ist getrennt vom heutigen Veröffentlichungsstand zu prüfen.
Die Einführung anhand von Messungen entscheiden
Synthetische Daten sind ein Entwicklungswerkzeug, kein Grund, Produktionsversuche auszulassen. Führen Sie das System stufenweise ein und lassen Sie, soweit möglich, die bisherige Prüfung parallel laufen. Bewahren Sie Modellversionen für Rücksetzungen auf, messen Sie Verarbeitungszeit auf der realen Hardware und definieren Sie die Reaktion auf unbekannte Objekte oder Lichtbedingungen. Das NIST AI Risk Management Framework fordert grundsätzlich Tests vor Einführung und regelmäßige Bewertung während des Betriebs.
Checkliste vor Budget- oder Auftragsfreigabe
- Veränderte Renderingvariablen sowie Versionen von Renderer und Assets dokumentieren.
- Einen getrennt erhobenen realen Holdout-Satz für Training und Abstimmung sperren.
- Falsche Annahmen und Ausschleusungen je Fehlerklasse vor und nach synthetischer Ergänzung vergleichen.
- Mit Lieferant, Charge oder Lichtbedingungen testen, die in keinem Trainingssatz vorkamen.
- Reale Beispiele jeder Fehlerklasse mit den generierten Defekten vergleichen.
- Rücksetzverfahren, Driftüberwachung und Verantwortliche festlegen.
Was dieser Leitfaden nicht nachweist
Die Planungshilfe berichtet keine Tests, bewertet keine NVIDIA- oder Drittanbieterwerkzeuge und beziffert keinen allgemeinen Nutzen synthetischer Daten. Dieser hängt von Teilen, Optik und Fehlern ab. Der Beitrag bewertet keine Konformität. Eine Prüfung, die eine Sicherheitsentscheidung beeinflusst, benötigt eigene Validierung durch qualifizierte Beteiligte.
Quellen und weitere Prüfung
- NVIDIA — Ankündigung des offenen Physical AI Data Factory Blueprint (Herstellermitteilung mit zukunftsgerichteten Aussagen vom 2026-03-16; ursprüngliche Prüfung 2026-10-12).
- NIST — AI Risk Management Framework 1.0: Govern, Map, Measure, Manage (Rahmen von 2023; laut NIST ist eine Überarbeitung in Arbeit; ursprüngliche Prüfung 2026-10-12).
Der nächste sinnvolle Schritt
Bereiten Sie reale Bilder guter und fehlerhafter Teile, Fehlerdefinitionen, vorhandene CAD-Daten sowie Kamera- und Beleuchtungsaufbau für die Seite Robotik und Automation vor. Das AYXWORKS-Portfolio erläutert den Ansatz. Ein daraus entstehendes Eurobots/ReBots-Projekt beginnt mit Machbarkeit und Zuständigkeiten, nicht einer vorausgesetzten schlüsselfertigen Installation.
Bildnachweis: ayxworks — eigene Darstellung, Rechte beim Herausgeber.